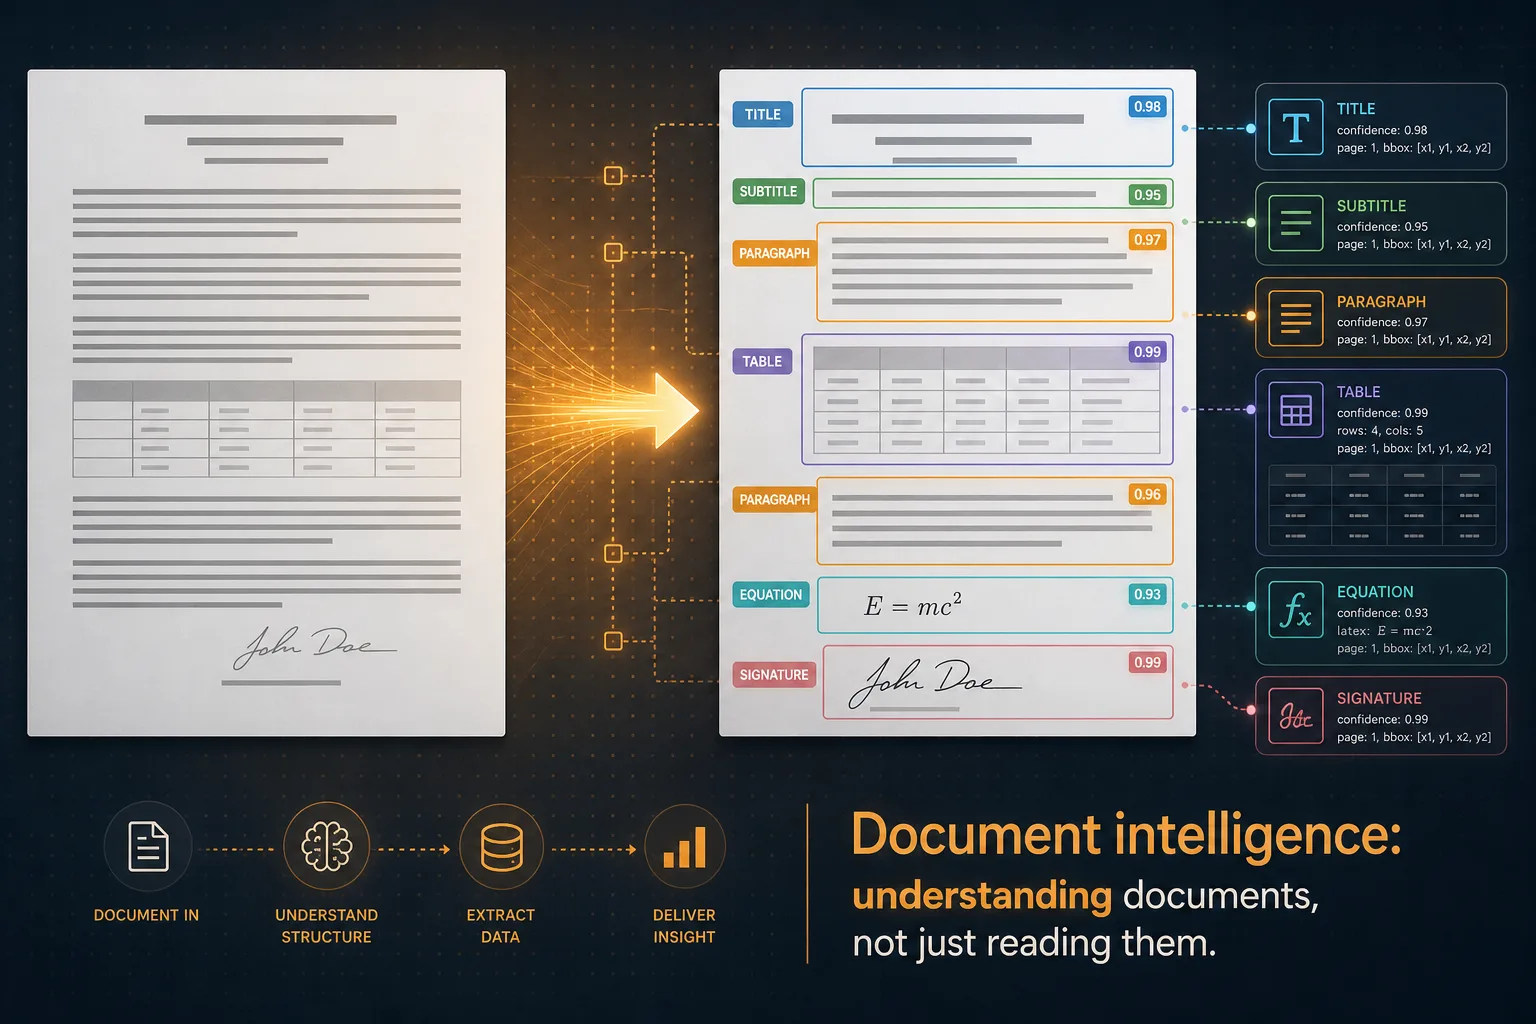
6 月 23 日,Mistral AI 发布了 OCR 4,这是它约 15 个月内的第四代光学字符识别模型——也是迄今最清晰的信号,表明这家法国实验室把进入企业预算的最快路径押在文档处理、而非聊天上。这次的核心转变是概念性的:旧式 OCR 把一页变成一串扁平文本,而 OCR 4 返回的是整份文档的结构化表示。
有什么新东西
OCR 4 抽取的每个块,现在都会附带三层额外元数据——而这些过去往往要靠下游系统自己重建:
| 能力 | 它做什么 | 为何重要 |
|---|---|---|
| 边界框 | 用坐标定位页面上的每个块 | 你知道每个元素在哪,而不只是它说了什么 |
| 块分类 | 按类型给块打标签——标题、表格、公式、签名等 | 为 RAG 启用结构感知的分块与路由 |
| 置信度分数 | 页级与词级的确定性数值 | 只把低置信度区域路由给人工复核 |
Mistral 把这个模型定位为小而专注:它接受 PDF、DOC、PPT 与 OpenDocument 文件,支持 横跨 10 个语族的 170 种语言(对低资源文字有意做了提升),并始终返回同一份载荷——抽取内容、边界框、块类型、置信度分数与 markdown。更上层的 Document AI 层在同一引擎之上加入了 schema 驱动的 JSON 输出与基于提示的解读。
按公司自己的说法,独立标注者在所有受测系统中都更偏好 OCR 4,平均胜率达 72%——不过 Mistral 异常坦诚地指出 OCR 基准存在已知局限,因此请把这个数字当作方向性而非定论。
自托管才是真正的头条
最可能赢下订单的特性不是准确率——而是模型在哪里运行。OCR 4 足够紧凑,可以作为单一容器部署在组织自有的基础设施上。这让银行、医院、律所与公共部门买家在抽取敏感文档时,无需让任何一页经过受美国司法管辖的云 API。
这是一个结构性差异,而非便利性问题:AWS Textract 与 Google Document AI 都是仅云的。对受数据驻留规则约束的受监管行业而言,一个本地部署、具结构感知的 OCR 正是 Mistral 切入的缺口——并且与公司在欧洲 AI 主权上的更广叙事相吻合。
定价与可用性
| 产品 | 价格 | 备注 |
|---|---|---|
| OCR 4(API) | $4 / 1,000 页 | 核心模型端点 |
| OCR 4(Batch API) | $2 / 1,000 页 | 高并发异步任务 5 折 |
| Document AI | $5 / 1,000 页 | schema 驱动、应用级输出 |
OCR 4 现已通过 Mistral API、Mistral Studio 中的 Document AI、Amazon SageMaker 与 Microsoft Foundry 提供,Snowflake Parse Document 支持即将到来。自托管按需向企业客户提供。
为何重要
对 Mistral 而言,OCR 是一个楔子。该模型是公司开源 Search Toolkit(现处于公测)的摄取层,把原始文件转换为可引用、按结构分类的输入,供检索增强生成与企业搜索使用。一旦某家公司在抽取环节标准化采用 OCR 4,Mistral 栈的其余部分——推理模型与其智能体平台——便顺理成章成为下一笔采购。
几点启示:
- 文档 AI 正向模型层整合。 边界框与置信度分数过去需要单独的视觉流水线;把它们打包进一个端点,为构建 RAG 与智能体栈 的团队省去了一整个预处理阶段。
- 主权如今是产品特性,而非口号。 单容器部署直指那些无法使用仅云对手的买家。
- 经济性很激进。 在每 1,000 页 $2–$5 的价格下——并有一位早期客户称其准确率相当、成本约为此前供应商的 1/8——OCR 正变得便宜到足以跑遍整个文档归档。
如果你正在梳理 Mistral 在前沿厂商中的位置,参见我们完整的 AI 模型目录 与 2026 LLM 全景指南。
关于数字的说明:定价与可用性以 Mistral 公告及发布时的报道为准;基准胜率来自公司自己的评测,且它承认该评测存在局限。在据此决策前,请在 Mistral 官网核实当前定价与部署选项。
来源
- Mistral AI — OCR 4: SOTA OCR for Document Intelligence (official announcement)
- VentureBeat — Mistral launches OCR 4, turning document extraction into a full enterprise AI play
- MarkTechPost — Mistral OCR 4 brings citation-ready structured output to RAG and search pipelines
- The Next Web — Mistral OCR 4: cheap, self-hosted document AI