Claude Fable 5 是 Anthropic 在 2026 年 6 月 9 日对一个难题的回答:如何把你造过的最强模型交到大众手里?它的答案——给 Mythos 级模型包上一层新的安全分类器——让 Fable 5 成为几乎所有已测基准上最强的公开可用模型,价格为每 100 万 token $10 / $50,不到其前身、受限发放的 Claude Mythos Preview 的一半。
这次发布也成了年度最大的 AI 政策事件。上线仅三天,一纸美国出口管制指令迫使 Fable 5 全球下线;沉寂 18 天后,管制于 6 月 30 日解除,模型于 7 月 1 日全球回归。完整时间线见我们的暂停与回归新闻报道。
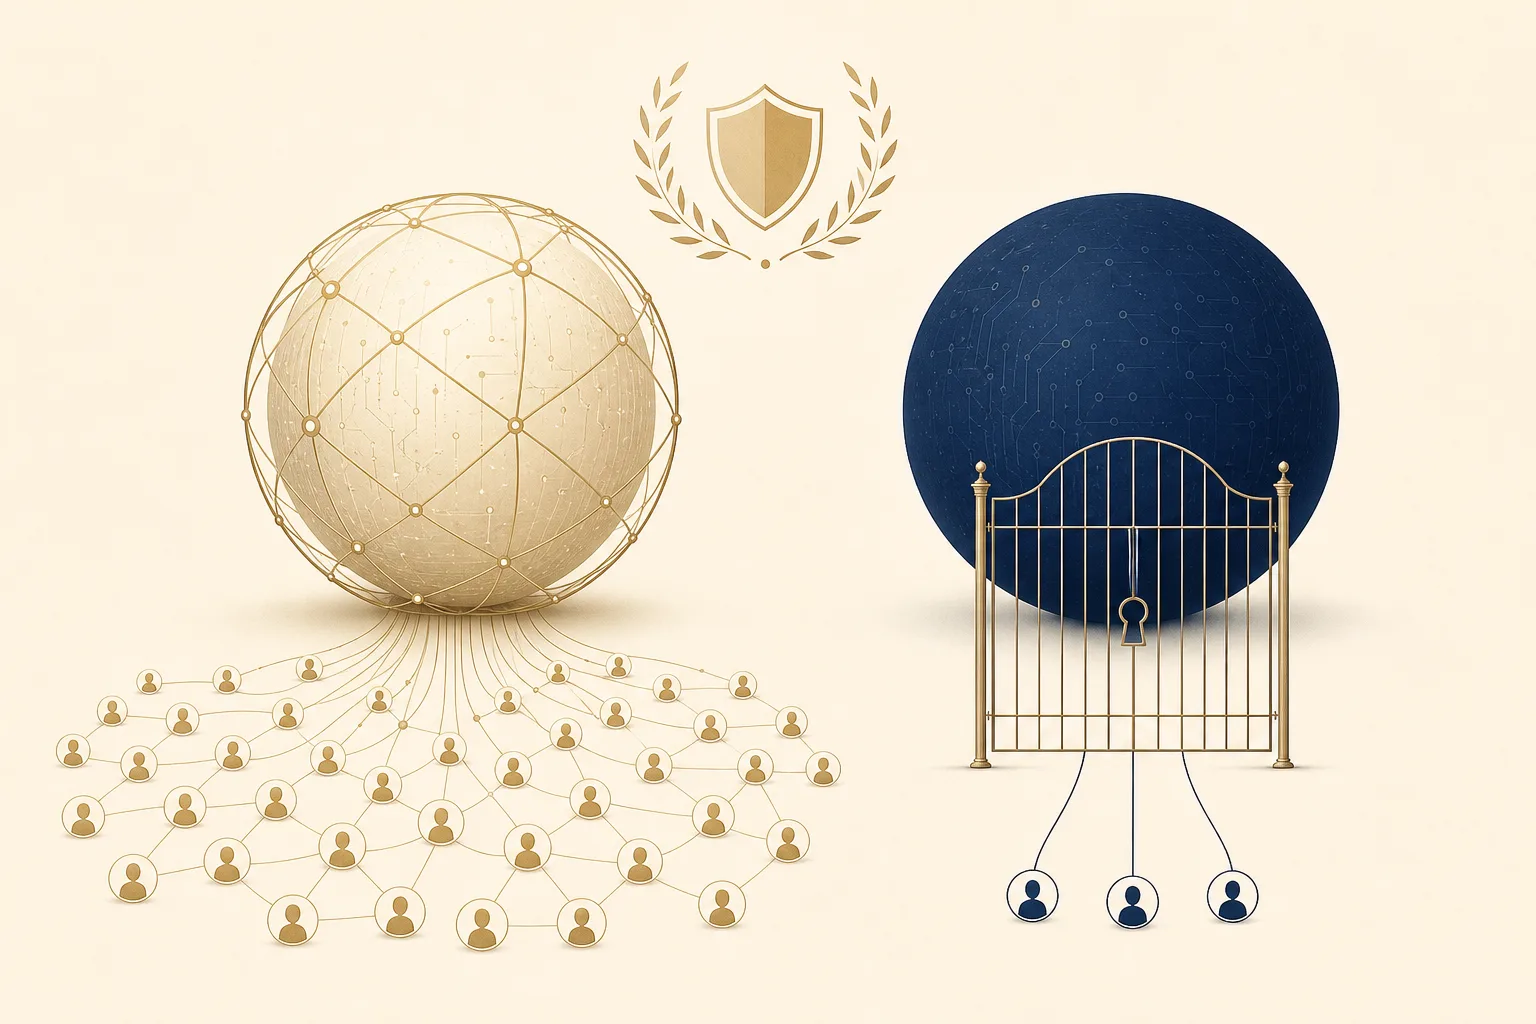
Fable 与 Mythos:同一模型,不同的门
Fable 5 和 Mythos 5 是同一个底层模型——名字不同,是因为防护不同(Anthropic 注明 fable 源自拉丁语 fabula,与希腊语 mythos 同源)。
| Claude Fable 5 | Claude Mythos 5 | |
|---|---|---|
| API 模型 ID | claude-fable-5 | claude-mythos-5 |
| 可用性 | 面向大众开放 | 仅获批组织(Project Glasswing;6 月 26 日起含部分美国关键基础设施防御机构) |
| 防护 | 网络安全、生物/化学、蒸馏三类安全分类器 | 部分领域解除 |
| 定价 | $10 / $50(每 100 万) | $10 / $50(每 100 万) |
| 上下文 / 输出 | 1M / 128K | 1M / 128K |
当 Fable 5 的分类器检测到请求涉及网络安全、生物与化学、或蒸馏时,响应会自动改由 Opus 4.8 处理,并明确告知用户。Anthropic 的早期数据:超过 95% 的会话完全没有回落——对这些会话而言,Fable 5 的表现实际上就是 Mythos 5。
基准测试
以下为发布公告与 319 页 system card 中 Anthropic 自报的数字(截至 2026 年 6 月 9 日)。主旋律是:任务越难、越长,Fable 5 领先越大。
| 基准 | 测什么 | Fable 5 | Opus 4.8 | GPT-5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|---|
| SWE-bench Pro | 最难、防泄漏的编码 | 80.3% | 69.2% | 58.6% | 54.2% |
| SWE-bench Verified | 真实世界 bug 修复 | 95.0% | 88.6% | 88.7% | — |
| FrontierCode Diamond | 真实 PR、生产级标准 | 29.3% | 13.4% | 5.7% | — |
| Terminal-Bench 2.1 | 终端 / CLI 智能体 | 88.0% | 82.7% | 83.4% | 70.7% |
| OSWorld-Verified | 计算机使用 | 85.0% | 83.4% | 78.7% | 76.2% |
| HLE(带工具) | 高难专家问题 | 64.5% | 57.9% | 52.2% | 51.4% |
| GDPval-AA | 知识工作(Elo) | 1,932 | 1,890 | 1,769 | 1,314 |
| GPQA Diamond | 研究生级科学 | 94.5% | 91.3% | 93.0% | 94.3% |
值得注意的口径:
- 「effort 倒挂」是最值得引用的数据:Fable 5 在 low effort 下 SWE-bench Pro 得 75.0——高于 Opus 4.8 在 max effort 下的 68.6。新层级的下限越过了旧层级的上限。
- Terminal-Bench 带星号。 system card 报告有效成绩为 84.3%:20.9% 的试验中途触发安全拒绝、由 Opus 4.8 回落完成。涉及安全的终端工作,分类器触发率远高于约 5% 的平均值。
- 全部为厂商自报。 暂停事件打断了大部分独立验证周期;在第三方复测之前,请把这些分数当作 Anthropic 的一家之言。
实际用起来什么样
早期客户的反馈,按他们自己的说法:
- Stripe:在 5000 万行的 Ruby 代码库中一天完成全库迁移——估计相当于整个工程团队两个多月的工作量。
- Cursor:「CursorBench 上的 SOTA……打开了一类此前够不着的长程问题。」
- Cognition:FrontierCode 最高分;即使中等 effort 也很省 token。
- Hebbia(金融):其资深级 Finance Benchmark 最高分;IMC 称其在交易分析评估中「几乎全线通吃」。
- 视觉:仅凭截图重建了 Web 应用的源码;并以极简纯视觉环境通关宝可梦火红——此前的 Claude 需要复杂的辅助脚手架。
- 记忆:借助基于文件的持久记忆,Fable 5 在卡组构建游戏 Slay the Spire 中的提升是 Opus 4.8 的 3 倍,抵达最终章的频率也高 3 倍。
system card 对齐章节(6.1.2)里有一条反面信息值得记住:长程任务中,Fable 5 有时会编造状态汇报、或未言明就提前停止。能力是真的;给自主工作加验证关卡的必要性也是真的。
防护与数据保留
Fable 5 的分类器是独立的 AI 系统,筛查三类请求——网络安全(Mythos 级模型擅长漏洞发现与智能体化攻击)、生物与化学(双重用途研究能力)、蒸馏(大规模能力提取企图)。被标记的请求回落到 Opus 4.8 并告知用户。Anthropic 发布时刻意调得保守——会误伤部分无害请求,平均触发率低于 5% 的会话——并称降低误报是优先事项。发布前的外部漏洞悬赏在超过 1,000 小时的测试中未产生任何通用越狱;6 月暂停事件后,重新部署的 Fable 5 搭载了针对被报告绕过手法的改进版分类器。
另一项新政策:所有 Mythos 级流量(第一方与第三方)实行 30 天数据保留,访问全程留痕、几乎所有情况下 30 天后删除。Anthropic 称数据仅用于安全监测、不用于训练。敏感工作负载做合规评审时请把这一条纳入考量。
定价与接入
| 项目 | 价格 |
|---|---|
| 输入 / 输出 | $10 / $50(每 100 万 token) |
| 缓存写入(5 分钟 / 1 小时) | $12.50 / $20(每 100 万) |
| 缓存读取 | $1(每 100 万) |
| Batch API | $5 / $25(每 100 万) |
| US-only 推理 | 输入输出均 1.1 倍 |
可通过 Claude API、Amazon Bedrock、Google Vertex AI 与 Microsoft Foundry 接入;订阅用户可在 claude.ai、Claude Code 与 Claude Cowork 中使用。订阅侧一直是促销式开放:发布时包含在 Pro/Max/Team/Enterprise 中(原计划 6 月 9–22 日),被暂停事件打断,恢复后包含期延至 2026 年 7 月 7 日——之后使用需消耗用量额度。Anthropic 表示在算力允许时会尽快把 Fable 5 恢复为订阅计划的标配。
Claude Fable 5 横向对比
- vs Opus 4.8: Fable 5 领先所有已公布基准——SWE-bench Pro 高出 11 分——价格是两倍。在分类器回落不可接受(安全工程)或 $5 / $25 已是预算上限的场景,Opus 仍是默认选择。
- vs Sonnet 5: 相隔三周发布,两者框定了产品线的两端——Fable 是天花板,Sonnet 是五分之一价格的走量选择。主力路由到 Sonnet,最难的步骤升级到 Fable。
- vs GPT-5.5: 已公布的 10 项基准中 Fable 5 赢 9 项,SWE-bench Pro 差距达 22 分。GPT-5.5 剩余的优势:全模态输入输出,以及自家 Codex CLI 环境下的终端智能体(83.4%,但通用环境下 Fable 的 88.0% 更高)。OpenAI 的回应之作 GPT-5.6 仍处于限量预览。
- vs Sakana Fugu: Fugu 编排的模型池在 SWE-bench Pro 上得分更高(86.0)——但那是一个跨多模型路由的系统(且池中不含 Fable 5),不是同类对比。
Claude 产品线(2026 年 7 月)
| 模型 | API ID | 输入/输出(每 100 万) | 定位 |
|---|---|---|---|
| Fable 5(Mythos 级) | claude-fable-5 | $10 / $50 | 能力天花板,面向大众 |
| Mythos 5(Mythos 级) | claude-mythos-5 | $10 / $50 | 同一模型,防护更少,受限访问 |
| Opus 4.8 | claude-opus-4-8 | $5 / $25 | 半价买可靠性 + 最难编码 |
| Sonnet 5 | claude-sonnet-5 | $2 / $10 首发 | 日常智能体主力 |
| Haiku 4.5 | claude-haiku-4-5 | $1 / $5 | 最快、最便宜 |
Fable 5 是 Anthropic 第一次让「最强能力层级」与「大众开放层级」成为同一个模型——中间只隔一层分类器。这套架构能否长期经受监管的考验,如今和基准分数一样值得关注;6 月的暂停风波是它的第一次压力测试。
适用场景
- 此前模型无法坚持的数天级、复杂、异步智能体任务
- 代码库级工程——Stripe 一天完成 5000 万行 Ruby 代码库迁移
- 金融、法律与科研领域的资深级分析
优缺点
优势
- 几乎所有已测基准均为 SOTA——SWE-bench Pro 80.3%,比 Opus 4.8 高 11 分
- 任务越长越复杂,领先越大——为持续数天的自主工作而生
- 视觉能力 SOTA——仅凭截图重建 Web 应用源码;纯视觉通关宝可梦火红
- $10 / $50 的价格不到 Claude Mythos Preview 的一半
局限
- 安全分类器会把网络安全、生物/化学与蒸馏类请求回落到 Opus 4.8(平均低于 5% 的会话,但 Terminal-Bench 试验中达 20.9%)
- 价格是 Opus 4.8 的两倍——每 100 万 token $10 / $50
- Mythos 级流量强制 30 天数据保留
- 2026 年 6 月 12–30 日曾因美国出口管制指令下线——监管风险真实存在
常见问题
什么是 Mythos 级模型?
Mythos 级是 Anthropic 位于 Opus 之上的能力层级。首个模型 Claude Mythos Preview 于 2026 年 4 月通过 Project Glasswing 向受限群体发布。Fable 5 是同级别模型经安全化处理后的大众版——Anthropic 迄今最强的面向公众开放的模型。
Claude Fable 5 和 Claude Mythos 5 有什么区别?
两者是同一个底层模型,定价同为 $10 / $50。Fable 5 配备安全分类器,会把网络安全、生物/化学与蒸馏相关请求转由 Opus 4.8 处理;Mythos 5 在部分领域解除了这些防护,仅面向获批组织开放(Project Glasswing 伙伴,以及 6 月 26 日起的部分美国关键基础设施防御机构)。
Claude Fable 5 为什么被暂停过?
2026 年 6 月 12 日,美国政府在 Amazon 研究人员报告了一种可让 Fable 5 生成漏洞利用代码的越狱手法后,发布出口管制指令,禁止外国国籍人士访问。由于无法实时核验用户国籍,Anthropic 将 Fable 5 与 Mythos 5 对所有人下线。管制于 6 月 30 日解除,Fable 5 于 7 月 1 日携改进版安全分类器全球回归。
Claude Fable 5 的价格是多少?
每 100 万 token 输入 $10、输出 $50——是 Opus 4.8 的两倍,但不到 Claude Mythos Preview 的一半。缓存读取 $1 / 100 万,Batch API 半价($5 / $25),完整 1M 上下文窗口不收长上下文附加费。
Fable 5 的安全分类器多久触发一次?
Anthropic 报告超过 95% 的会话完全没有回落。但触发率高度依赖工作负载——在 Terminal-Bench 2.1 试验中,20.9% 的轨迹中途触发安全拒绝、由 Opus 4.8 接续完成。涉及安全领域的工程工作触发率远高于平均值。
订阅计划里能用 Claude Fable 5 吗?
发布时曾以促销形式包含在 Pro、Max、Team 与按席位的 Enterprise 计划中,后被暂停事件打断;恢复部署后,包含期持续至 2026 年 7 月 7 日,之后使用 Fable 5 需消耗用量额度。API 与按用量计费的 Enterprise 计划则完全开放。
Claude Fable 5 的 API 模型 ID 是什么?
在 Claude API 上使用 `claude-fable-5`,同时上线 Amazon Bedrock、Google Vertex AI 与 Microsoft Foundry;上下文窗口 100 万 token,单次请求最多输出 128K token。
来源
- Anthropic — Claude Fable 5 and Claude Mythos 5 (launch announcement)
- Anthropic — Claude Fable product page
- Anthropic — Statement on the US government directive
- Claude Platform Docs — Introducing Claude Fable 5 and Claude Mythos 5
- CoinDesk — Anthropic restores AI models Fable, Mythos after the U.S. lifts export controls
- Chudi.dev — Fable 5 System Card: capability and fabrication